其他AI

Meta Segment Anything Model 2

用于高精度分割图像和视频中的对象的统一模型。

价格以官网为准编辑评分 未评分
访问官网 ↗

产品与联系信息

使用平台
网页版
语言支持
未注明
资料更新
2026-11-03
ai.meta.com
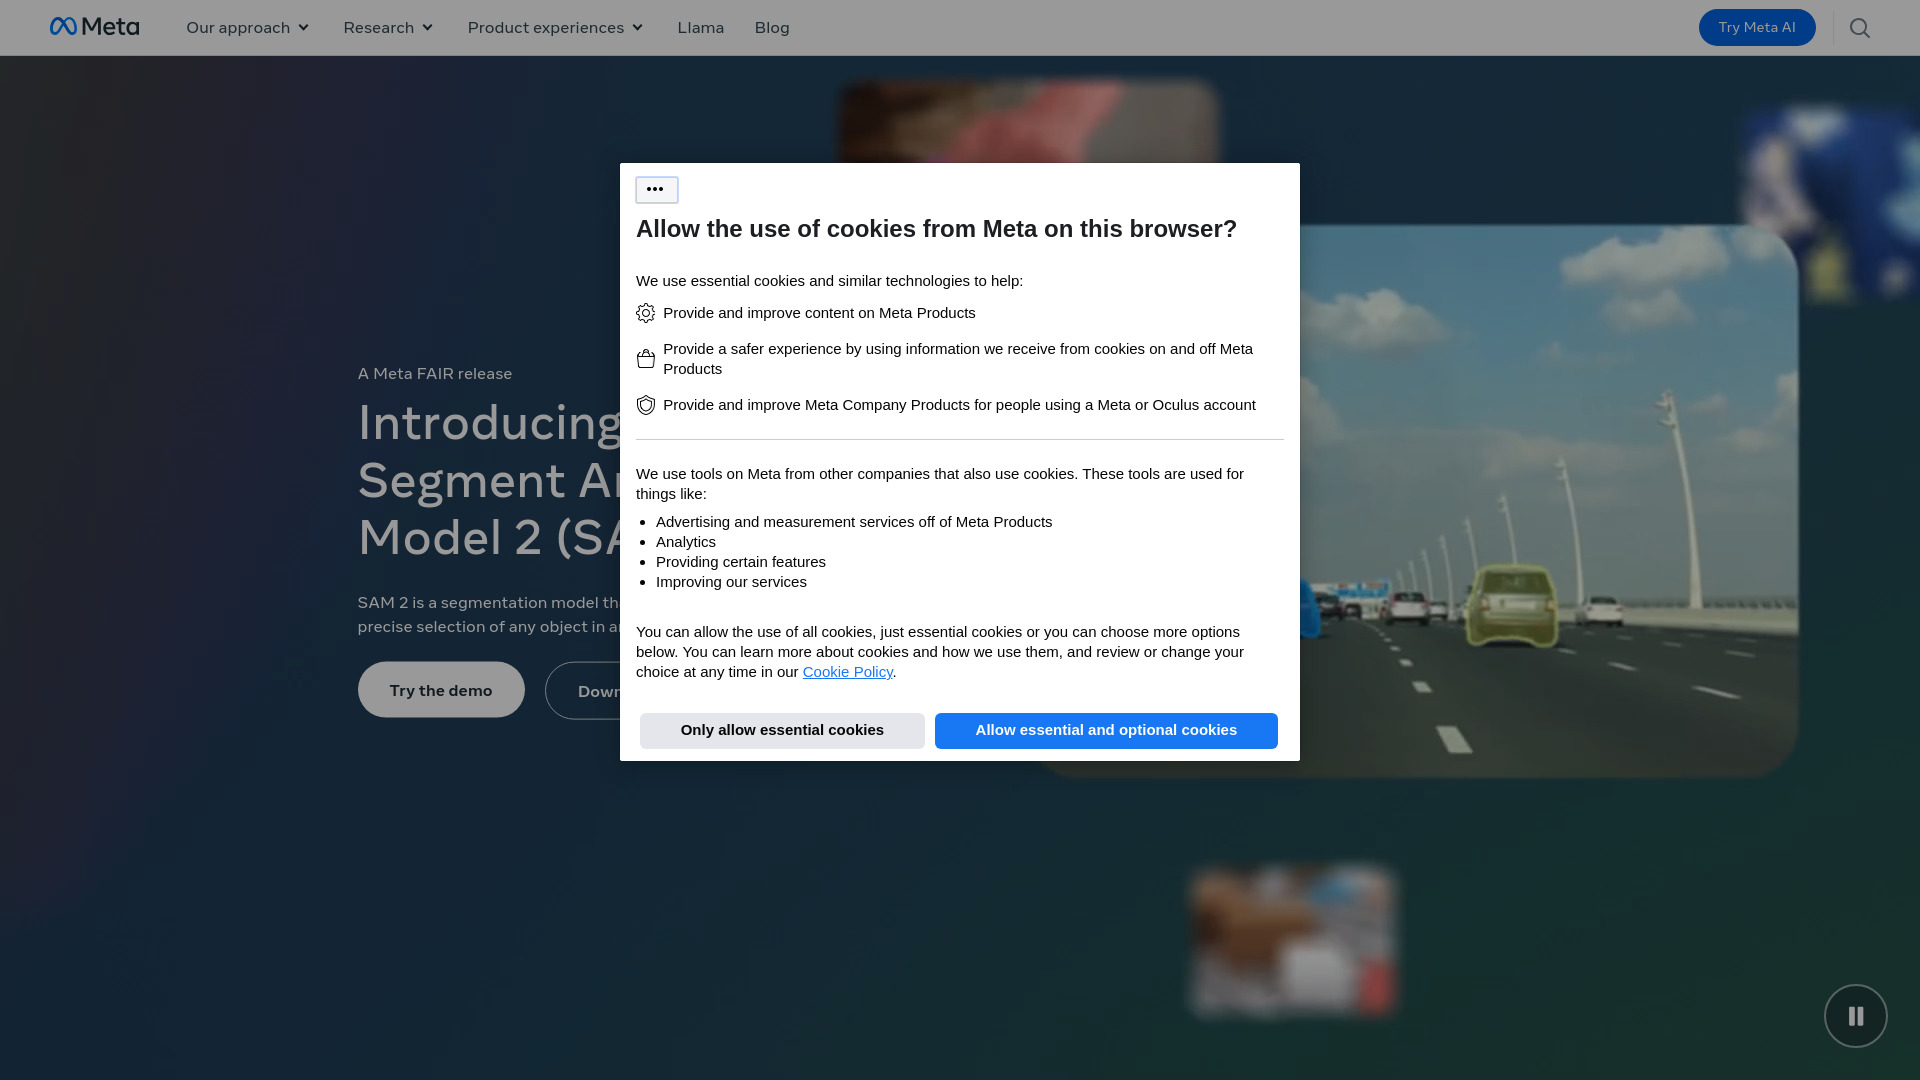
Meta Segment Anything Model 2 产品截图查看大图 ↗
Meta Segment Anything Model 2 产品截图图片来源 ↗产品页面预览

核心能力

5 项
  • 统一的图像和视频分割
  • 使用点击、框选或遮罩进行交互式对象选择
  • 实时交互和结果
展开全部 5 项
  • 统一的图像和视频分割
  • 使用点击、框选或遮罩进行交互式对象选择
  • 实时交互和结果
  • 在陌生视频和图像上的鲁棒零-shot性能
  • 最先进的对象分割性能

典型使用场景

4 项
  • 在视频帧中选择和跟踪对象
  • 使用额外提示细化对象分割
  • 在视频生成模型中实现精确编辑功能
展开全部 4 项
  • 在视频帧中选择和跟踪对象
  • 使用额外提示细化对象分割
  • 在视频生成模型中实现精确编辑功能
  • 创建具有实时视频处理的交互式应用程序

快速上手

1 项
  • 快速上手

    用户可以通过提供点击、框选或遮罩作为输入,在图像或视频帧中选择对象。模型将根据提供的提示对对象进行分割。可以使用额外的提示来细化模型的预测,特别是在视频帧中。

查看完整说明
  • 快速上手

    用户可以通过提供点击、框选或遮罩作为输入,在图像或视频帧中选择对象。模型将根据提供的提示对对象进行分割。可以使用额外的提示来细化模型的预测,特别是在视频帧中。

工具详细介绍进一步了解 Meta Segment Anything Model 2 的产品定位与使用说明展开阅读收起介绍

Meta Segment Anything Model 2 (SAM 2) 是首个统一模型,用于对图像和视频中的对象进行分割。它允许用户通过点击、框选或遮罩作为输入,在任何图像或视频帧中选择对象。SAM 2 旨在实现快速、精确的对象选择,并在图像和视频的对象分割方面提供最先进的性能。这些模型是开源的,遵循 Apache 2.0 许可证。

适合人群

  • 人工智能研究人员
  • 计算机视觉工程师
  • 视频编辑
  • 内容创作者
  • 人工智能应用开发者

产品优势

  • 统一模型用于图像和视频
  • 开源并遵循 Apache 2.0 许可证
  • 强大的零-shot性能
  • 实时交互性
  • 最先进的分割性能

使用注意

  • 在复杂场景中可能需要额外的提示以获得最佳结果
  • 性能可能因视频质量和对象可见性而异
产品表现洞察

Meta Segment Anything Model 2 数据分析

官网访问趋势、地区分布与流量渠道

更新于 2026-11-03

最新流量情况

月访问量 (2026-09)
366.70万
平均访问时长
00:01:06
每次访问页数
1.59
跳出率
72.99%

访问量采用最近明确月份的曲线值;其余指标按概览区间展示。

2024-05 - 2026-09 全部流量

访客国家与地区

5 个地区

2024-05 - 2026-09 桌面设备

美国37.12%
印度12.29%
加拿大4.61%
中国3.43%
韩国3.38%

流量来源渠道

10 个渠道

2024-05 - 2026-09 全球桌面设备

自然搜索 73.93%直接访问 13.03%自然社交 5.58%外部推荐 5.51%AI 引荐 1.25%邮件 0.40%付费社交 0.12%展示广告 0.08%付费搜索 0.07%联盟推广 0.02%10个流量渠道
自然搜索73.93%
直接访问13.03%
自然社交5.58%
外部推荐5.51%
AI 引荐1.25%
邮件0.40%
付费社交0.12%
展示广告0.08%
付费搜索0.07%
联盟推广0.02%

热门搜索关键词

公开搜索表现
关键词 流量 点击费用
muse 220.00万 $ 0.78
meta ai 190.00万 $ 0.37
meta muse 77.00万 $ 1.52
muse ai 110.00万 $ 1.33
muse meta 31.18万 $ 1.02

常见问题

4 个问题
什么是 Meta Segment Anything Model 2 (SAM 2)?

SAM 2 是一个统一模型,用于对图像和视频中的对象进行分割,允许用户通过点击、框选或遮罩作为输入选择对象。

SAM 2 是开源的吗?

是的,这些模型是开源的,遵循 Apache 2.0 许可证。

SAM 2 接受什么样的输入?

SAM 2 接受点击、框选或遮罩作为输入来选择图像或视频帧中的对象。

什么是 SA-V 数据集?

SA-V 数据集是一个大型而多样化的视频分割数据集,用于训练 SAM 2。它包括在地理上多样的真实场景中收集的 ~60万个遮罩,涵盖 ~5.1万段视频。

评论与评分

总评分
请选择

正在载入评论…

真实会员评论,审核通过后公开展示。回复不重复计入评分。

探索更多相关工具

更多同类工具

AI提示词

Snack Prompt

★ 4.0

适合发现热门 Prompt、收藏模板和分享经验。

提示词发现社区了解详情 →
模型AI

Hugging Face

★ 4.5

模型、数据集和应用社区最丰富的平台之一。

模型与社区平台了解详情 →
视频AI

Runway

★ 4.5

适合视频生成、编辑、特效和创意短片制作。

AI 视频创作平台了解详情 →
对话AI

Perplexity

★ 4.6

以搜索为核心的 AI 答案引擎,适合资料查找与调研。

搜索问答助手了解详情 →

安全验证

请完成验证后继续操作。